(通讯员:边睿骞)2026年9月13日下午13:00,我院特邀华东师范大学统计学院教授、博士生导师刘玉坤教授在北湖东校区数统新楼201室作学术报告。本次报告由数学与统计学院承办,会议由数学与统计学院副院长杨凯教授主持,学院院长王纯杰教授、统计系副主任王淑影教授、学院部分老师和研究生参加了本次学术报告会。
会议开始之际,由杨老师作为代表对刘老师的到来表示感谢,并对刘老师及其研究内容做了简单的介绍。
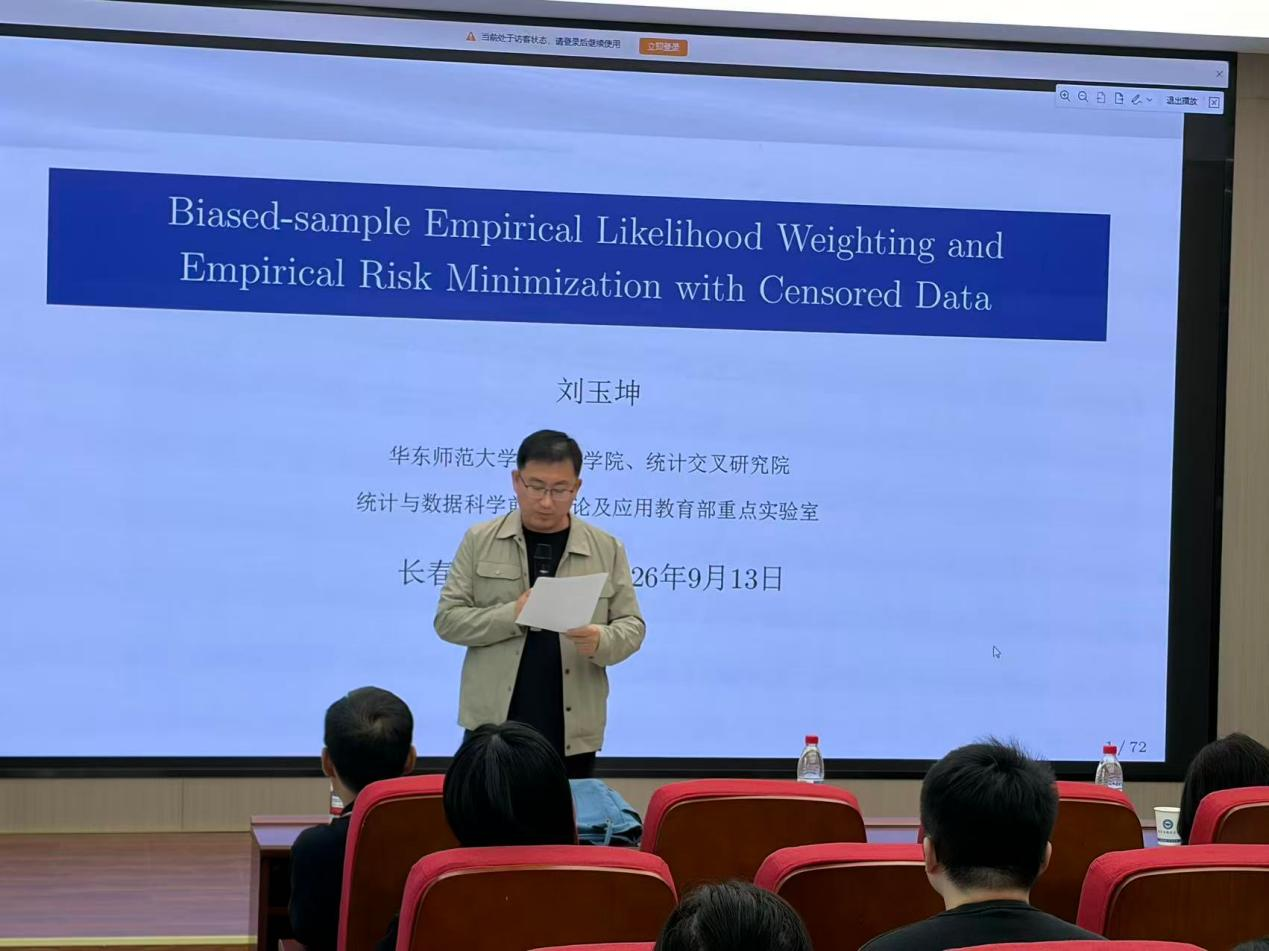
报告人简介:刘玉坤,华东师范大学统计学院教授、博士生导师。本科和博士毕业于南开大学统计系,之后一直在华东师范大学任教。研究兴趣包括分布偏移数据、因果推断、共形推断、半参数统计和机器学习等。成果曾发表在JRSSB、AOS、JASA、Biometrika、Biometrics、JOE等期刊和计算机顶会NeurIPS和ICLR等; 担任“生态安全智慧决策”教育部学科突破计划先导项目PI,主持科技部国家重点研发计划课题和国家自然科学基金项目。
报告题目:General risk minimization under random censorship with empirical likelihood weighting
报告摘要:Empirical Risk Minimization (ERM) serves as a foundational framework in statistical learning and machine learning, yet conventional ERM methods struggle with censored data, which are common in various fields. The inherent censoring mechanism generates incomplete observations that disrupt direct loss function evaluation. While inverse probability of censoring weighting (IPCW) methods--based on the conditional survival function $S_C(t|\bx)$--partially mitigate this issue, they exhibit severe instability as $S_C(t|\bx)$ approaches zero. We propose an empirical likelihood weighting-based ERM (ELW-ERM), which overcomes the instability issues associated with IPCW and accommodates general loss functions, including squared loss, logistic loss and quantile loss. We establish non-asymptotic or asymptotic error bounds on the excess risk of our ELW-ERM predictor under general conditions and three specific model assumptions. Our ELW-ERM is shown to achieve the same learning rates as classical ERMs in absence of censoring under the Cox model, and as the IPCW-based ERM under a fully nonparametric model. Under a general Cox model, with the help of deep neural networks, it is able to mitigate the curse-of-dimensionality issue when $S_{C}(t|\bx)$ has a low-dimensional structure. Numerical experiments and an empirical analysis demonstrate the effectiveness and superiority of our proposed ELW-ERM method.
刘教授首先介绍了什么是经验似然和逆概率加权,经验似然是一种非参数统计推断方法。它的核心思想是不预先假设数据服从某个特定的分布,而是利用数据本身来构造一个似然函数,从而进行参数估计和假设检验。逆概率加权是统计学和因果推断中一种非常核心的方法,主要用于处理选择偏差和混杂问题。它的核心思想是通过给样本赋予不同的权重,来构造一个伪总体,在这个伪总体中,处理组和对照组的协变量分布是均衡的,就像随机对照试验一样。
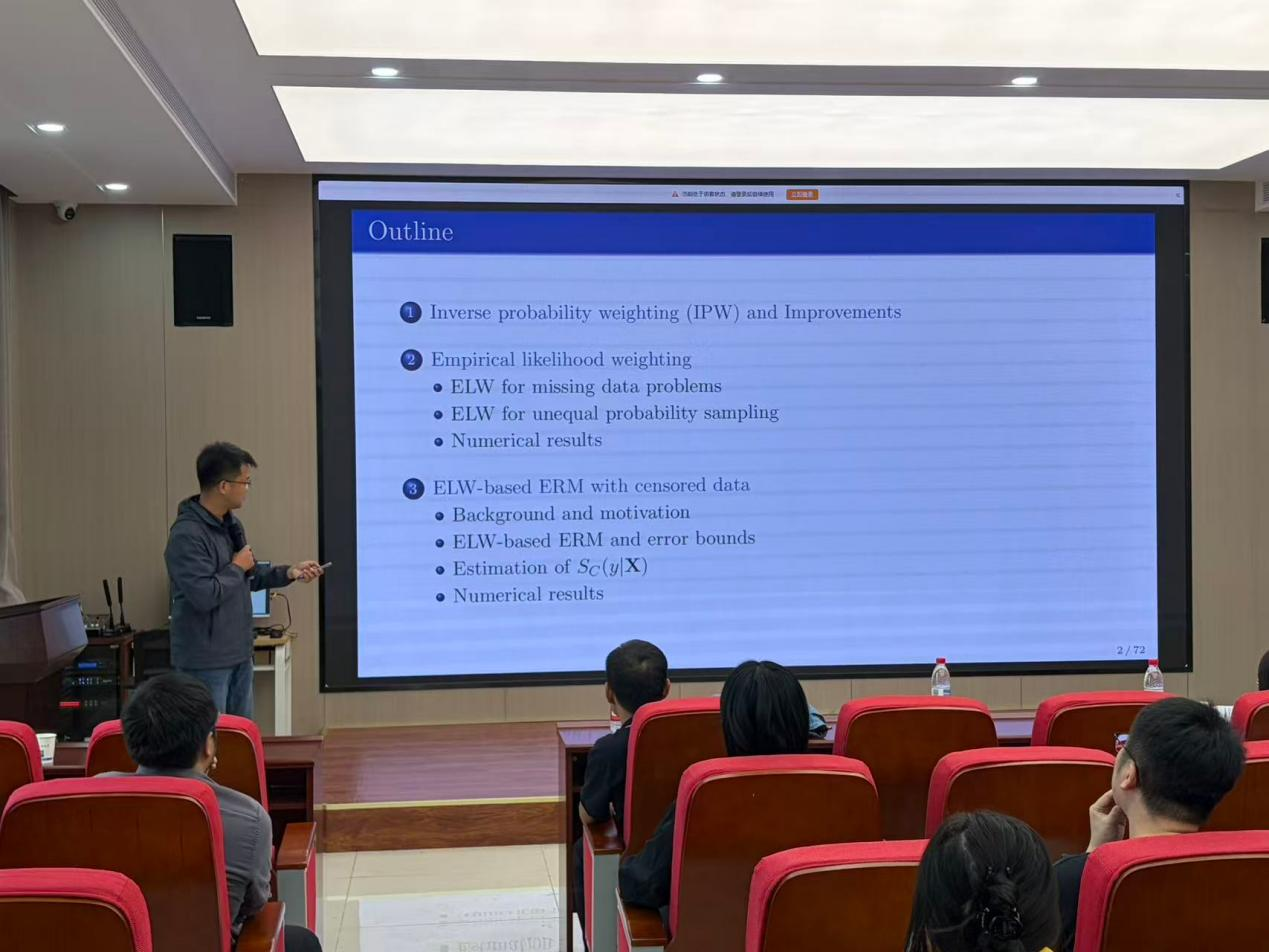
其次,他总结了在逆概率加权中处理极端权重的三种方法,它们分别是稳定化、门限化和截断。同时,他讲述了经验似然加权问题。经验似然加权是经验似然思想在加权场景下的自然延伸。它要解决的核心问题是当我们有辅助信息或面临样本选择偏差时,如何给每个样本分配一个既符合这些约束、又尽可能接近均匀分布的权重。
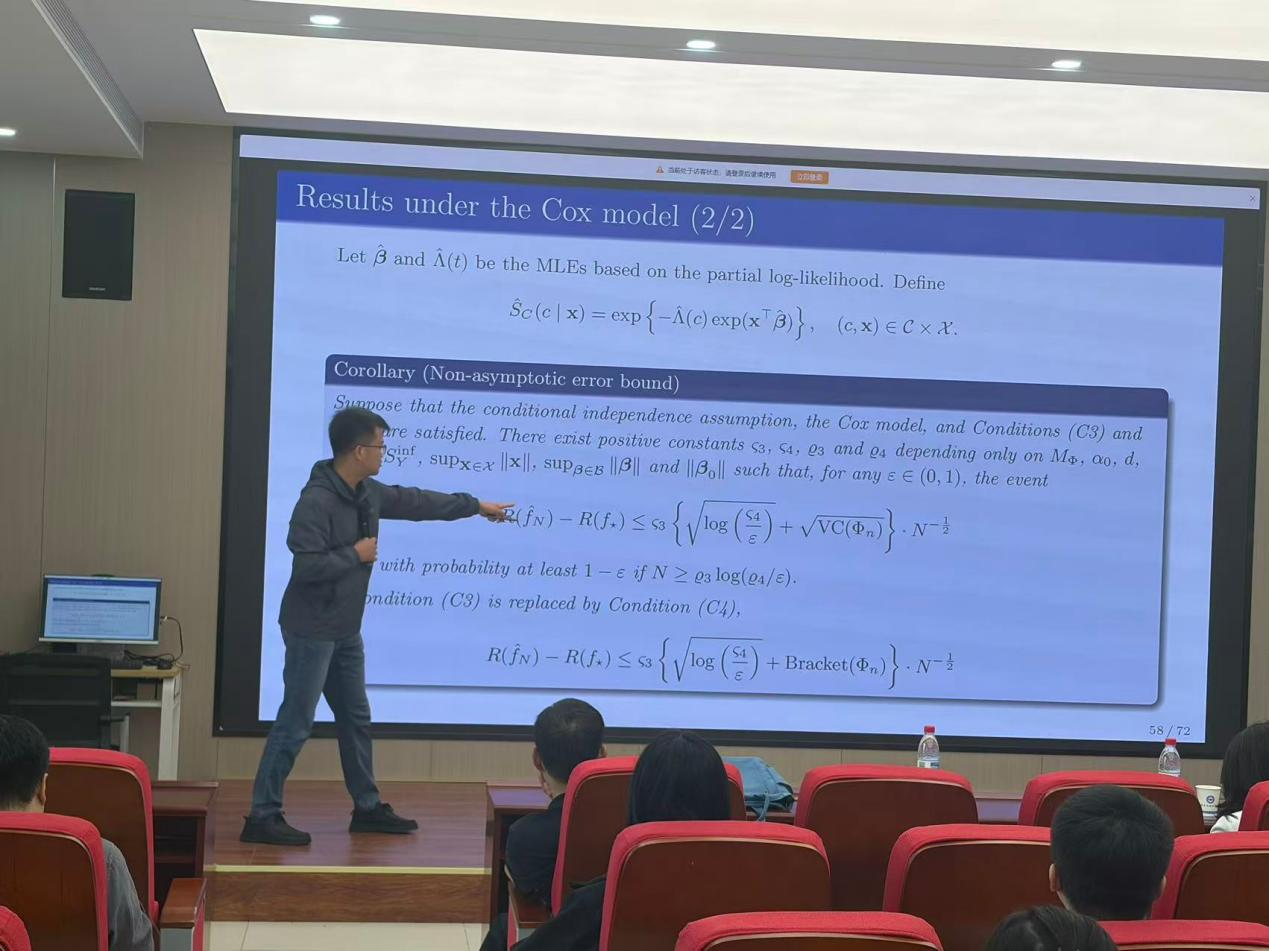
最后,刘教授将经验似然加权在删失数据下进行了研究,并分析了渐近误差带。对给定的有限样本直接成立,不需要让样本量趋于无穷大、不依赖大样本渐近定理。
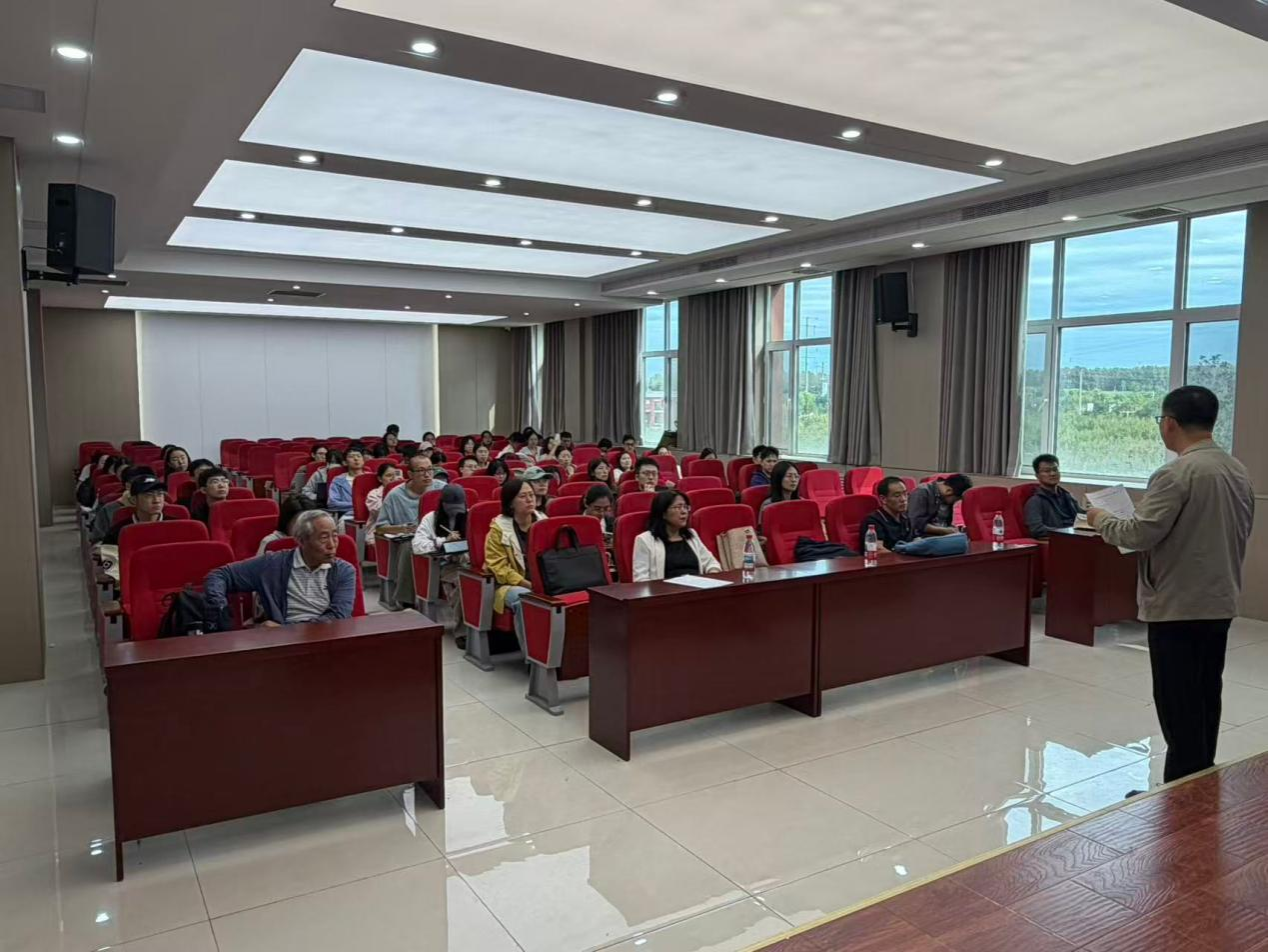
报告结束后,参会人员踊跃提问,就感兴趣的问题与刘老师进行了深入的讨论和交流。与在场师生深入交流的过程中,刘教授指出经验似然只是一个工具,未来还需与对应的实际例子进行结合,并做统计分析。聆听报告的师生均表示收获颇丰,并激发了大家的学习热情。
初审:关迪
复审:杨凯
终审:王丹、王纯杰
数学与统计学院
2026年9月14日