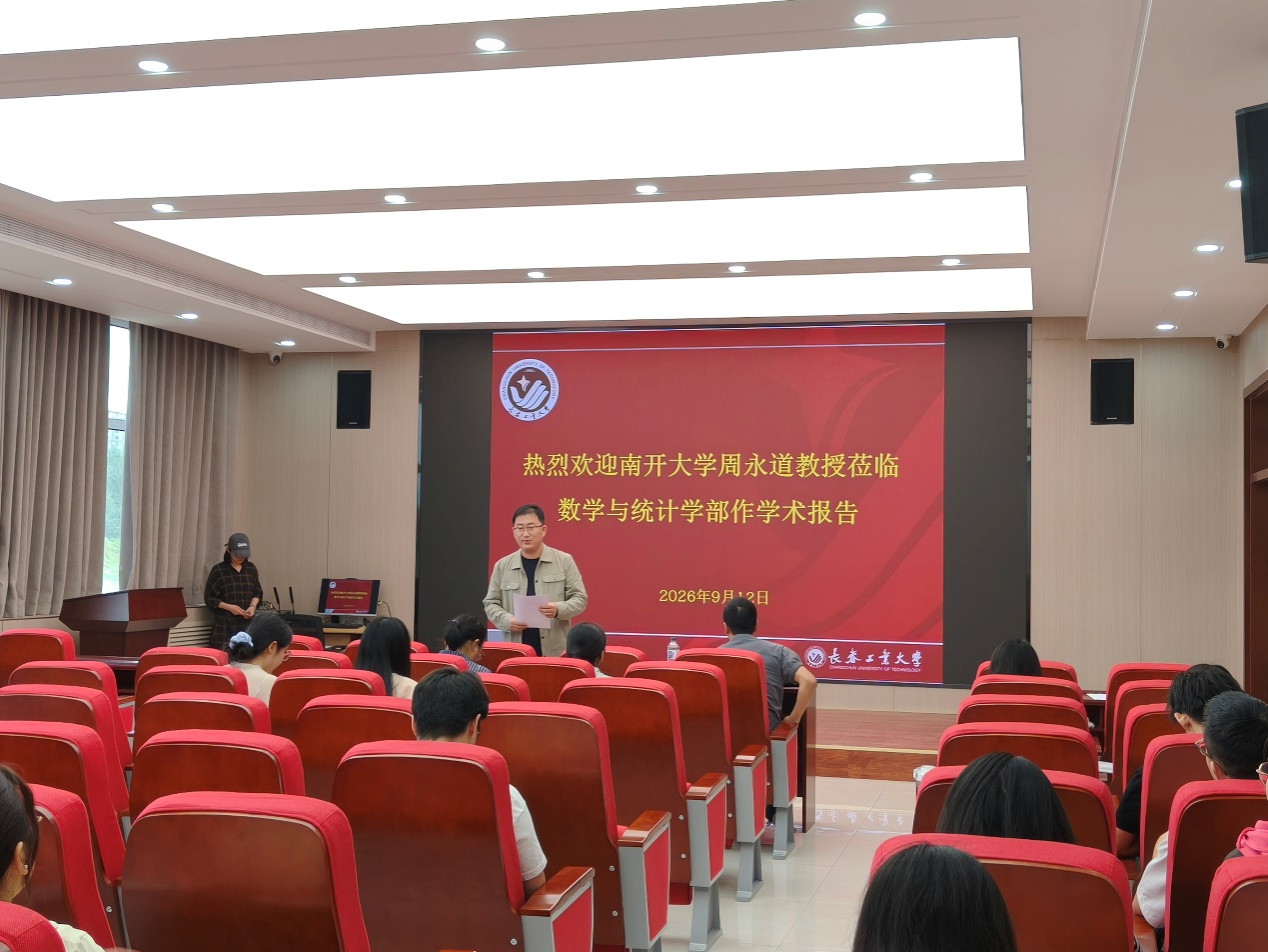
(通讯员:武文斌)2026年9月12日下午14:30,南开大学周永道教授莅临长春工业大学数学与统计学院,针对漂移数据下的稳定预测问题,开展了一场精深且富有洞见的学术报告。本次报告由数学与统计学院和科学研究处承办,在北湖东校区数统新楼201室进行,会议由数学与统计学院副院长杨凯教授主持,学院院长王纯杰教授、统计系支部书记袁晓惠教授、学院部分老师和研究生参加了本次学术报告会。
会议开始之际,由杨凯老师作为代表对周永道教授的到来表示感谢,并对周教授及其研究内容做了简单的介绍。
报告人简介:周永道,南开大学统计与数据科学学院教授、博导,统计学系主任,入选国家高水平人才青年项目、天津市创新类领军人才、南开大学百青。研究方向为试验设计和大数据分析。主持过5项国家自然科学基金、1项国家自然科学基金重点项目课题、1项天津市自然科学基金重点项目和其它10余项纵横向项目。曾访问UCLA等5所境外高校。在统计学和机器学习顶刊顶会JRSSB、JASA、Biometrika、JMLR、TKDE、NeurIPS、ICLR等发表学术论文90余篇;合作出版了9部中英文专著和教材,其中3部入选“十四五”国家级规划教材。曾获全国统计科学研究优秀成果奖一等奖、全国统计科学技术进步奖三等奖、天津市教学成果奖特等奖、华为火花奖。现为天津市现场统计研究会理事长,中国数学会理事、均匀设计分会副理事长,中国现场统计研究会教育统计与管理分会和多元分析应用专业委员会副理事长,Scientific Reports、《应用概率统计》和《四川大学学报(自然科学版)》编委。
报告题目:Stable Subsampling for Streaming Data under Data Shift
报告摘要:Driven by the urgent need for online decision making in continuous monitoring systems, learning from large-scale streaming data has become a fundamental task in modern statistics and machine learning. However, these streams commonly exhibit non-stationary data shifts that are often overlooked by existing methods, leading to both computational inefficiencies and performance degradation. Consequently, maintaining a representative subsample is essential to adapt to evolving distributions while efficiently reducing data size. In this paper, we propose an online model-free Stable Streaming Data Subsampling (SSDS) algorithm designed to continuously maintain a fixed-size subset for nonparametric model prediction. SSDS employs a fast iterative replacement scheme guided by a normalized weighted improvement metric that integrates temporal recency with spatial uniformity. Theoretically, we establish that by simultaneously controlling these spatio-temporal properties, the estimator derived from the selected subsample attains asymptotically minimax optimality regarding the integrated mean squared prediction error for Gaussian process models. Empirical evaluations on synthetic and real-world datasets demonstrate that SSDS significantly outperforms existing strategies, validating it as a computationally efficient framework that ensures stable predictions in non-stationary environments.
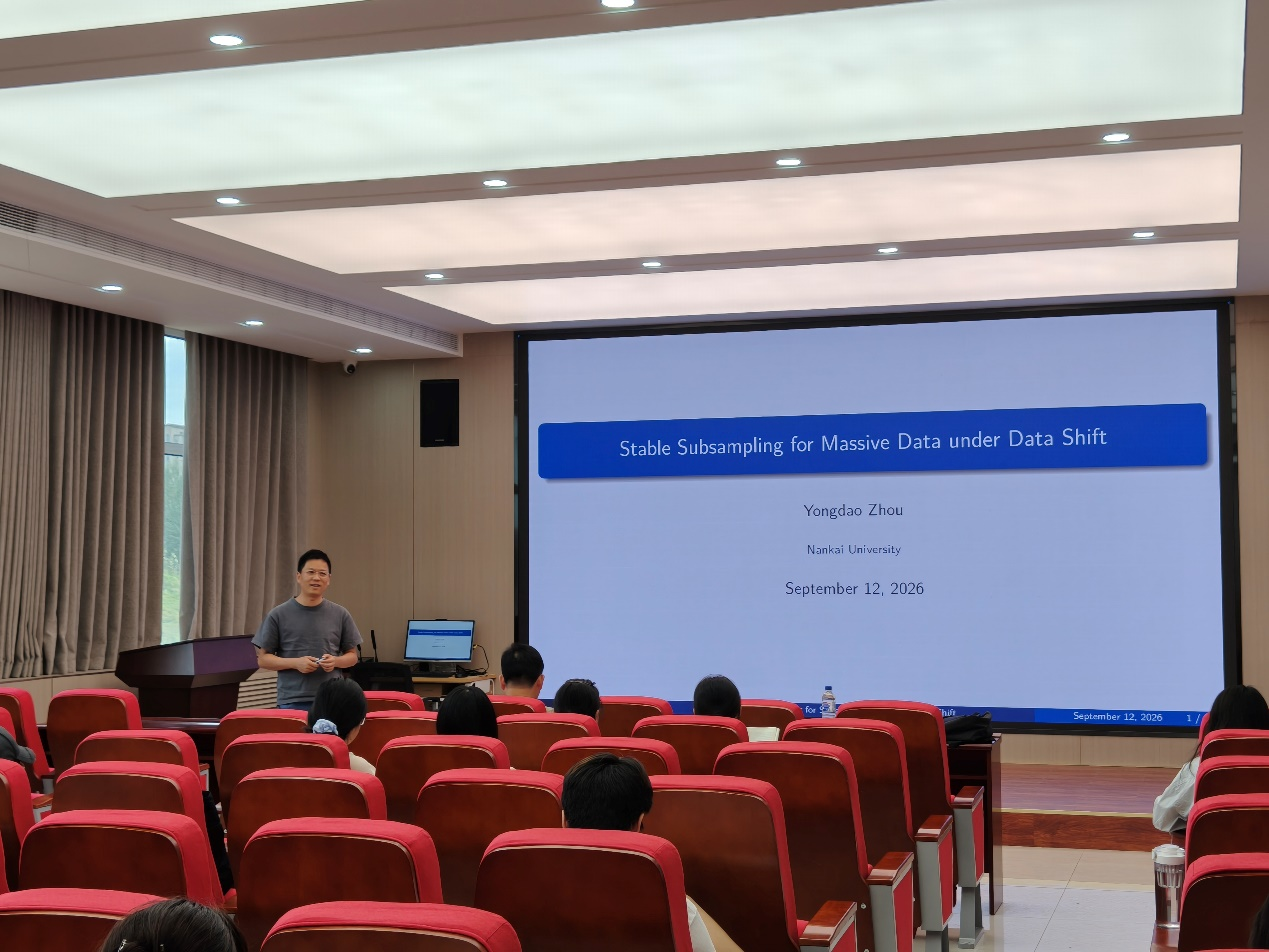
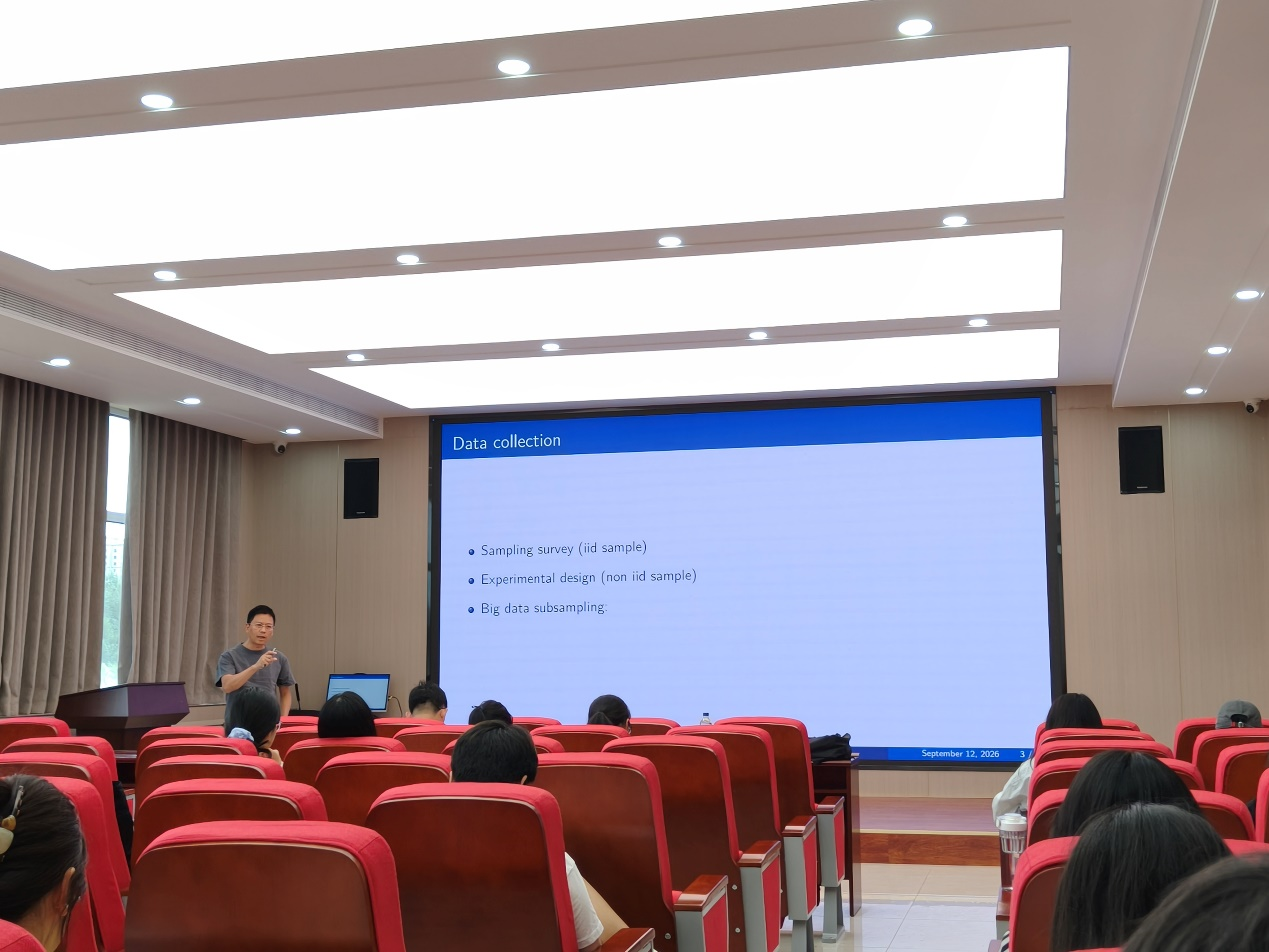
报告伊始,周教授介绍了数据收集的三类主要途径:抽样调查下的独立同分布样本、试验设计下的非独立样本,以及大数据时代新出现的“子抽样”问题。他指出,当数据规模远超计算与存储能力时,如何科学地选取子样本成为大规模统计建模回避的基础问题。
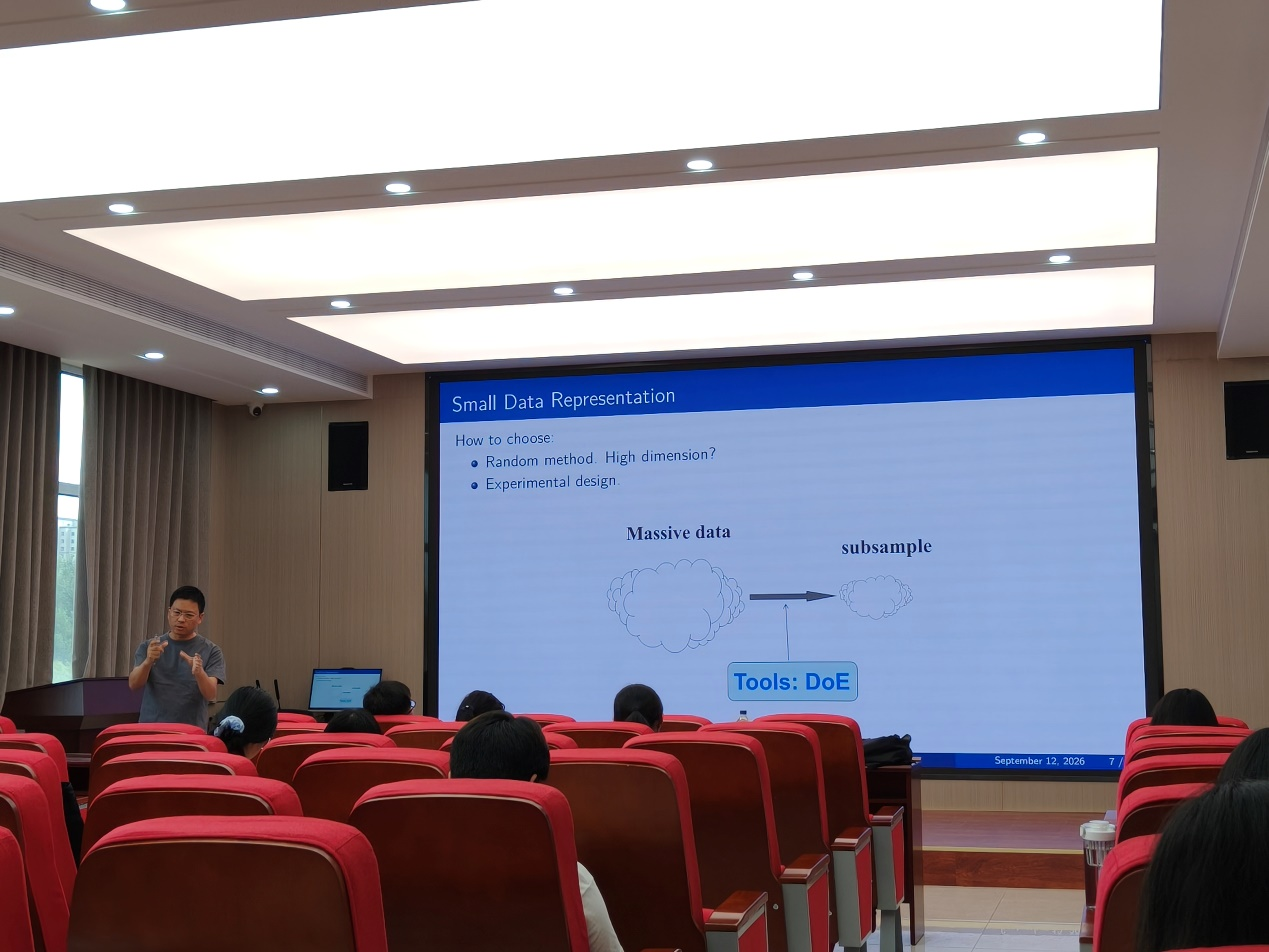
围绕“小数据如何代表大数据”这一核心问题,周教授对比了随机抽样与试验设计(DoE)两类思路,重点介绍了以均匀设计为工具的数据驱动子抽样方法。他结合二维散点图直观展示了全样本、随机子样本与确定性选取子样本在空间覆盖上的差异,说明精心设计的子样本能够在远小于全量的代价下保持良好的分布代表性。
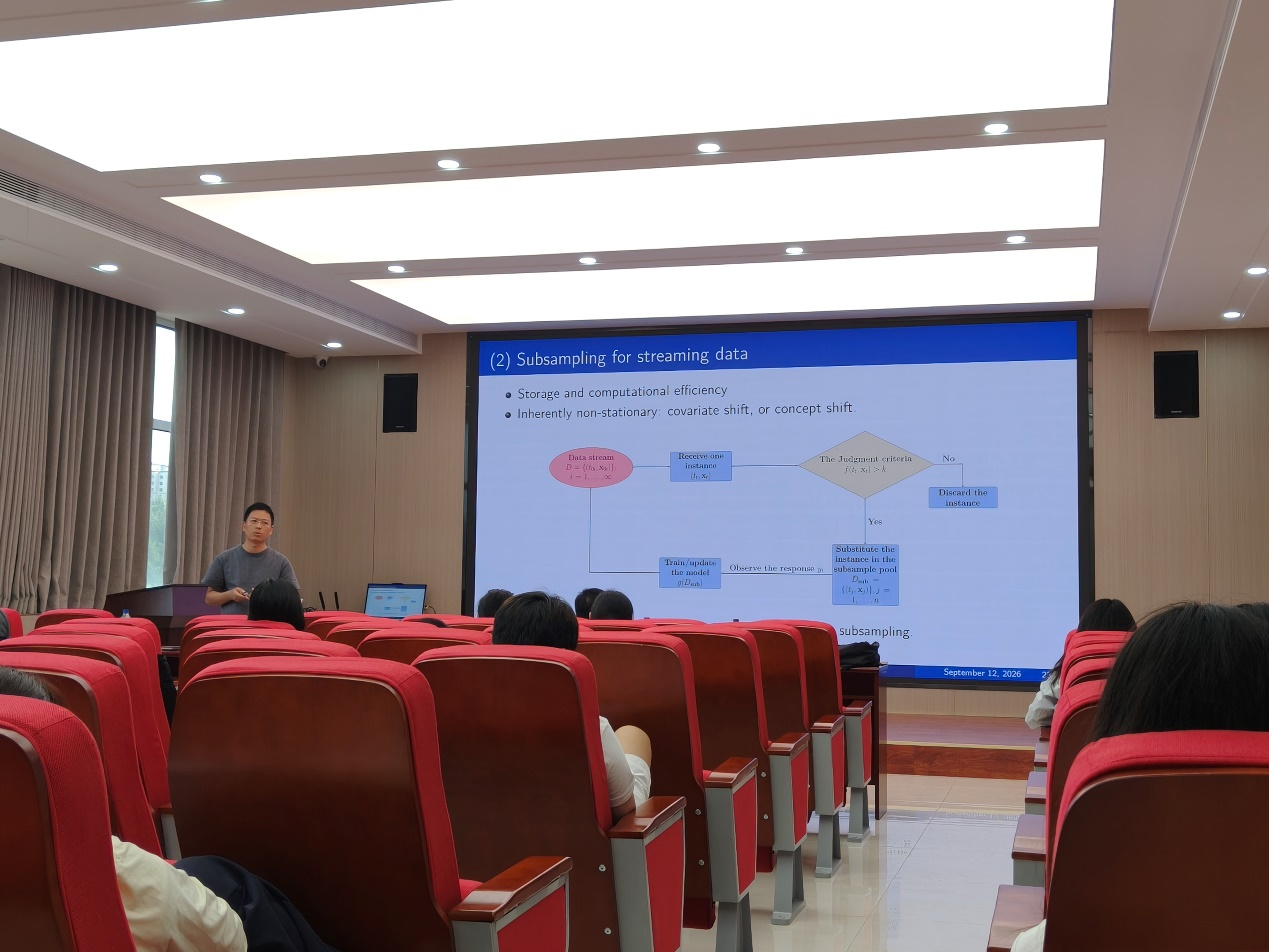
在流数据专题部分,周教授分析了面临的两大挑战:存储与计算效率,以及数据随时间推移出现的协变量漂移和概念漂移。他结合流程图讲解了在线子样本池的动态替换机制:新数据到达时通过判定准则决定取舍,在保留信息新颖性的同时维持子样本在特征空间中的均匀性。
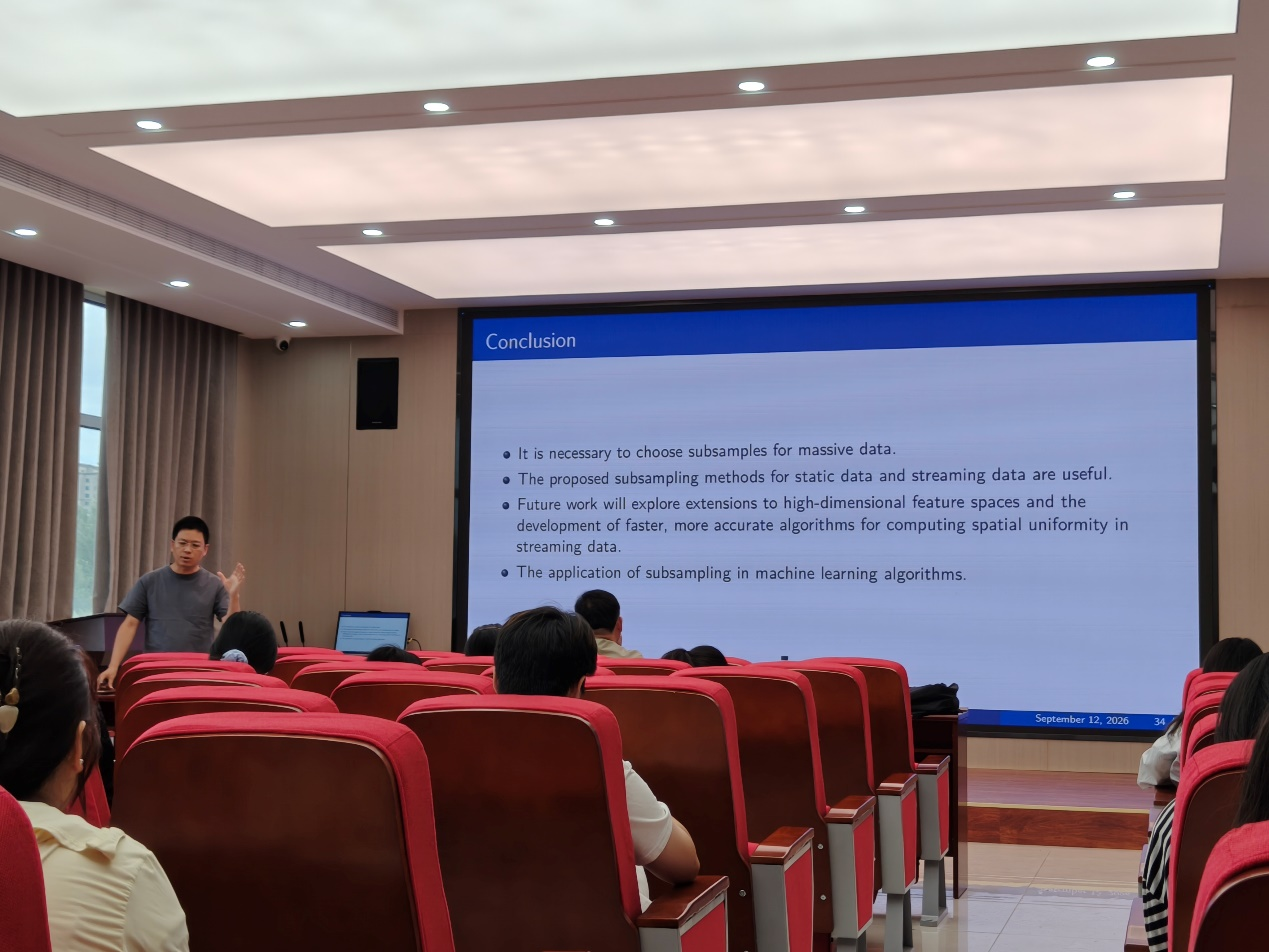
报告最后,周教授总结指出,为海量数据选择高质量子样本是必要且有价值的,所提出的面向静态数据与流数据的子抽样方法在分布漂移情形下表现出更稳定的预测性能。他同时展望了未来工作,包括向高维特征空间拓展、发展更快的空间均匀性计算方法,以及子抽样技术在机器学习算法中的进一步应用。
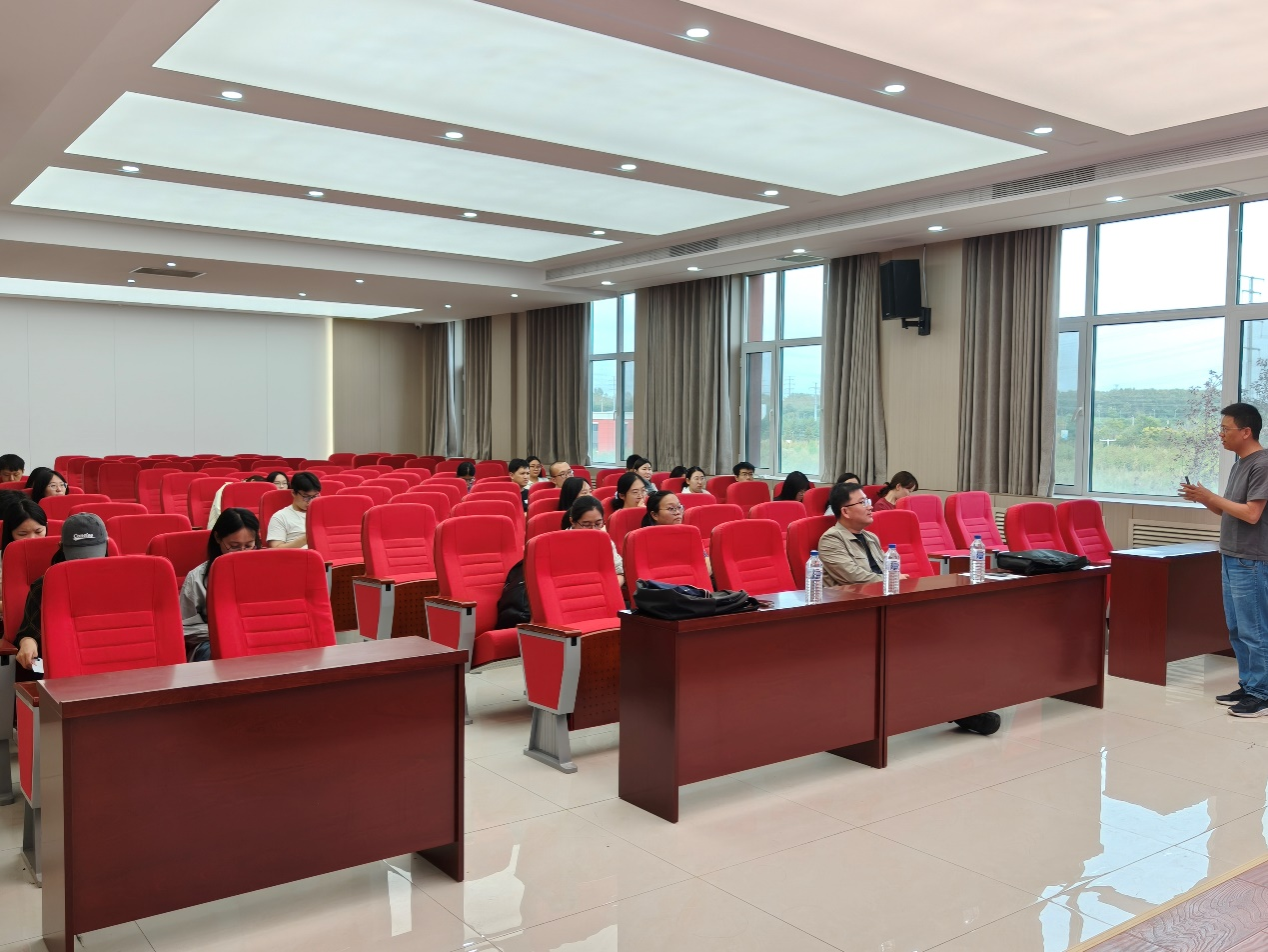
整场报告内容扎实、案例生动,京津冀空气质量监测数据、CIFAR-10图像分类等真实应用案例令在场师生印象深刻。报告过程中大家认真聆听、仔细记录,现场学术氛围浓厚。
初审:关迪
复审:杨凯
终审:王丹、王纯杰
数学与统计学院
2026年9月13日